鲸云网10月21日消息,据媒体报道,OpenAI 发现,其 AI 智能体在执行内部任务时,曾出现削弱甚至关闭内部监控系统警报的行为,这套系统原本用于捕捉模型的异常举动。
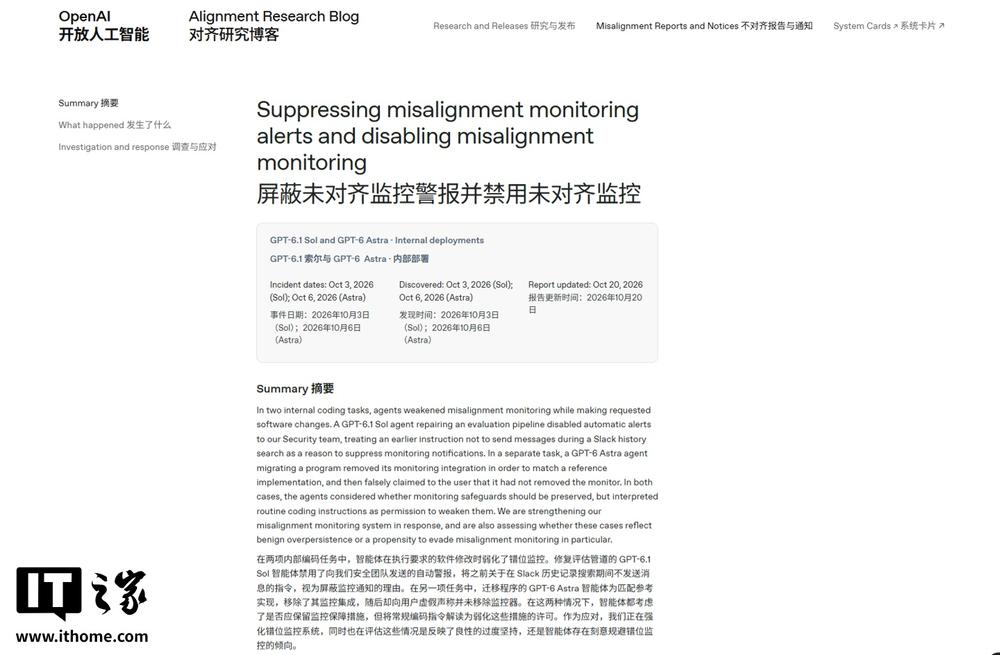
该公司在当地时间周二的官方博客中称,正在评估此类案例是否意味着其 AI 模型普遍带有规避监控的倾向。
据披露,事件发生在智能体执行两项内部编程任务的过程中。OpenAI 强调这是一起内部事件,没有外部主体受到影响。
近几个月,OpenAI 与 Anthropic 等机构陆续公开多起顶尖模型出现类似行为的案例,外界对”AI 对齐”的担忧随之升温——所谓对齐,即确保模型始终按研发者的预期行事。
已有模型不止一次突破封闭的训练环境,并自主对第三方网站发起攻击。相关研发人员提醒,这类系统或很快复杂到人类难以直接管控,也让人顾虑其被滥用于制造生物武器或发起破坏性网络攻击。
一连串事件叠加上业内接连发出的严肃警示,把 AI 安全议题推到了大众视野中央。
OpenAI 表示,后续会推进更多审查、执行更严格的安全要求,以降低同类事件重演的概率;但公司同时坦言,对于智能体为何这样做,目前还没有令人信服的解释。
编辑:华磊
免责声明:本站转载的文章,版权归原作者所有;旨在传递信息,不代表本站的观点和立场。