鲸云网10月22日消息,据媒体报道,在今日下午的科大讯飞全球 1024 开发者节活动上,科大讯飞宣布推出星火语音基座大模型 SparkAudio 1.0。
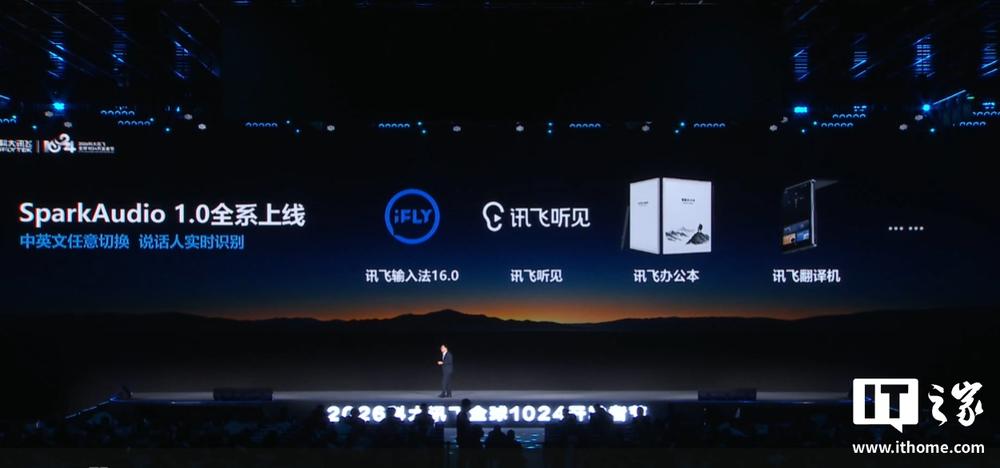
该模型整合了机器翻译、语音识别与语义理解等能力,基础语音处理能力较此前有明显提升。
官方介绍,SparkAudio 1.0 在实时说话人分离、环境理解、音频理解以及情绪识别等方面均有表现,方向是推动人工智能向物理世界场景落地。
现场演示中,模型对一段电影片段完成了声音内容、背景信息、说话人性别等维度的识别,并给出相应的场景判断。
SparkAudio 1.0 已在讯飞输入法 16.0、讯飞听见、讯飞办公本与讯飞翻译机中全面上线,支持中英文任意切换与说话人实时识别。
编辑:华磊
免责声明:本站转载的文章,版权归原作者所有;旨在传递信息,不代表本站的观点和立场。