鲸云网11月12日消息,据媒体报道,在今日举办的百度世界 2026 大会开幕式上,百度集团执行副总裁沈抖发布了百度天池 1024 卡超节点,这套算力集群计划于明年正式推向市场。
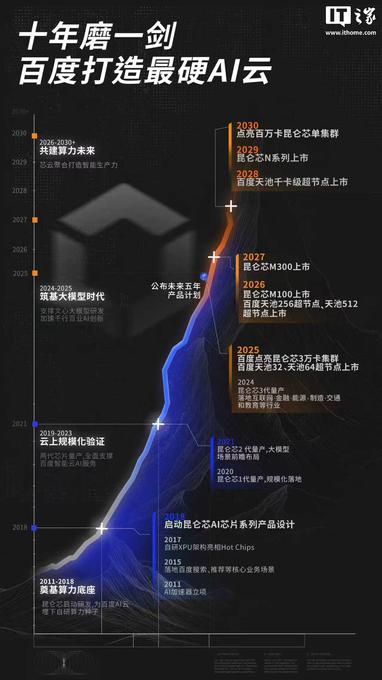
百度世界大会是百度每年一度的技术发布主场,天池超节点选在开幕式亮相,凸显出算力基础设施在该公司 AI 战略中的优先级。该超节点面向大规模 AI 训练与推理场景,官方称其可支撑高达 5 万亿参数的模型训练,这一规模已远超当前主流开源与商业大模型的参数体量,对应的是头部玩家对下一代超大模型的储备需求。
在硬件互联层面,天池 1024 卡超节点搭载业界领先的光引擎技术,卡间互联带宽较上一代提升 3 倍;得益于此,训练性能提升 2.5 倍、推理性能提升 3 倍,对比基准为百度此前一代产品。
配套软件与存储方面,节点引入 G3.5 KV Cache 显存加速柜,强化缓存复用能力,使长上下文推理性能再提升 2 倍,缓解了长序列场景下的显存压力。
在多轮对话缓存命中的典型场景里,首 token 等待时间(TTFT)降低 90%,整体吞吐提升 7 倍,这对客服、助手类长对话以及长文档生成等时延敏感应用较为关键。
百度以光互联叠加显存加速柜来突破单机柜的算力密度瓶颈,本质是同时去啃训练集群的”通信墙”与”显存墙”,让更大参数规模的模型能在更短时间内完成一轮迭代,缩短从数据到可用模型的周期。
国内大模型的竞争焦点正从早期单纯堆卡,转向单位算力的效率、稳定性与工程化能力;超节点这类一体化方案的出现,说明头部厂商在底层基础设施上的投入仍在加速,也反映出超大模型训练正在从”能不能跑”走向”跑得快不快、成本高不高”。
这类高密度算力集群在明年陆续落地后,5 万亿参数级别模型的训练门槛有望进一步下探,更多团队或得以参与前沿模型研发,但与此同时,能耗、散热与运维复杂度也会成为落地过程中必须直面的现实约束。
如需转载请务必注明出处:鲸云网 责任编辑:华磊